Desarrolla tu Copilot privado con RAG (Parte 4: FastAPI, VS Code y el choque de orquestadores)
Conectamos nuestro agente local directamente a VS Code. Cómo simular la API de OpenAI con FastAPI y las lecciones aprendidas al enfrentar dos orquestadores RAG en el mismo entorno.
Estás leyendo la parte 4 de 4.
- 1.Parte 1: Arquitectura y stack
- 2.Parte 2: Agente con enrutamiento
- 3.Parte 3: UI + métricas con Streamlit
- 4.👉 Parte 4: FastAPI, VS Code y el choque de orquestadores
En la tercera parte montamos una interfaz visual con Streamlit para interactuar con nuestro agente privado y tangibilizar el coste que nos estábamos ahorrando gracias al servidor de inferencia local. Pero siendo honestos: tener que cambiar constantemente de pestaña entre el IDE y el navegador rompe por completo el estado de trabajo.
El objetivo final de este proyecto siempre fue tener un Copilot integrado directamente en el IDE. Para lograrlo, vamos a conectar nuestro agente construido con LangGraph con VS Code utilizando Continue.dev, una extensión open source excelente para integrar IAs en el editor (aunque fue adquirida por Cursor en junio de este año y su desarrollo FOSS ya no es prácticamente activo, sigue siendo más que suficiente para esta demostración).
Lo que parece un paso trivial dio paso a un desafío. Al intentar integrar ambas piezas, salió a la luz un problema de arquitectura entre sistemas agénticos: el choque de orquestadores.
Primer paso: Disfrazar FastAPI de OpenAI
Continue.dev (y casi cualquier herramienta del ecosistema IA moderno) se entiende universalmente con el esquema de la API de OpenAI.
En lugar de escribir integraciones personalizadas, la solución más práctica es replicar exactamente ese mismo esquema utilizando FastAPI. Si levantamos un endpoint en POST /v1/chat/completions, Continue.dev creerá que está hablando con los servidores de OpenAI, cuando en realidad estará comunicándose con nuestro modelo local (en Ollama) a través de nuestro agente.
Para que esto funcionara, tuve que replicar con Pydantic los modelos de datos de OpenAI (ChatCompletionRequest, ChatCompletionChunk):
from pydantic import BaseModel
from typing import List, Optional

[...]

class ChatCompletionRequest(BaseModel):
    model: str
    messages: List[Message]
    temperature: Optional[float] = 0.0
    stream: Optional[bool] = False

[...]

class ChatCompletionChunk(BaseModel):
    id: str
    object: str = "chat.completion.chunk"
    created: int
    model: str
    choices: List[ChoiceChunk]
El punto delicado aquí es el streaming para evitar esperar turnos de forma síncrona. Usando el método asíncrono astream_events de la API de LangGraph, podemos capturar cada token generado por el nodo final (filtrando el evento on_chat_model_stream del nodo generate_node) e iterarlo vía Server-Sent Events (SSE) hacia el IDE. El output del LLM fluye en VS Code al instante.
from fastapi import FastAPI
from fastapi.middleware.cors import CORSMiddleware
from fastapi.responses import StreamingResponse
from langchain_core.messages import HumanMessage, SystemMessage, AIMessage

from src.schemas import ChatCompletionRequest, ChatCompletionChunk, ChoiceChunk, Delta, Message
from src.graph import app as copilot_app

app = FastAPI(
    title="Godot Local RAG Agent API",
    description="OpenAI API Compatible",
    version="1.0.0"
)

[...]

async def event_generator(request: ChatCompletionRequest) -> AsyncGenerator[str, None]:
    """Generador asíncrono para Server-Sent Events (SSE) compatible con OpenAI API."""

    [...]

    async for event in copilot_app.astream_events(initial_state):
        # Solo nos interesan los tokens generados por el nodo final ("generate_node")
        if event["event"] == "on_chat_model_stream" and event.get("metadata", {}).get("langgraph_node") == "generate_node":
            token = event["data"]["chunk"].content

            if token:
                chunk = ChatCompletionChunk(...)
                yield f"data: {chunk.model_dump_json(exclude_none=True)}\n\n"

    # Señal de fin de stream según specs de OpenAI
    yield "data: [DONE]\n\n"

[...]

@app.post("/v1/chat/completions")
async def chat_completions(request: ChatCompletionRequest):
    """Endpoint principal que intercepta las llamadas de Continue.dev."""
    if request.stream:
        return StreamingResponse(
            event_generator(request),
            media_type="text/event-stream"
        )
    else:
        # Implementación simplificada (Continue.dev suele usar siempre stream)
        return {"error": "Por favor, habilita 'stream: true' en la configuración de VSCode / Continue.dev."}
Configuré Continue.dev editando el fichero config.yaml de esta extensión y añadí un modelo bajo el proveedor openai, apuntando al servidor local levantado con FastAPI (http://localhost:8000/v1):
name: Main Config
version: 1.0.0
schema: v1
models:
  - name: Godot local RAG agent
    provider: openai
    model: qwen2.5-coder:14b
    apiBase: http://localhost:8000/v1
Levantamos el backend:
(.venv) juanma@mbp godot_local_rag_agent % uvicorn src.main:app --host 0.0.0.0 --port 8000 --reload
INFO:     Will watch for changes in these directories: ['/Users/juanma/dev/ai/godot_local_rag_agent']
INFO:     Uvicorn running on [http://0.0.0.0:8000](http://0.0.0.0:8000) (Press CTRL+C to quit)
INFO:     Started reloader process [20014] using WatchFiles
INFO:     Started server process [20028]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
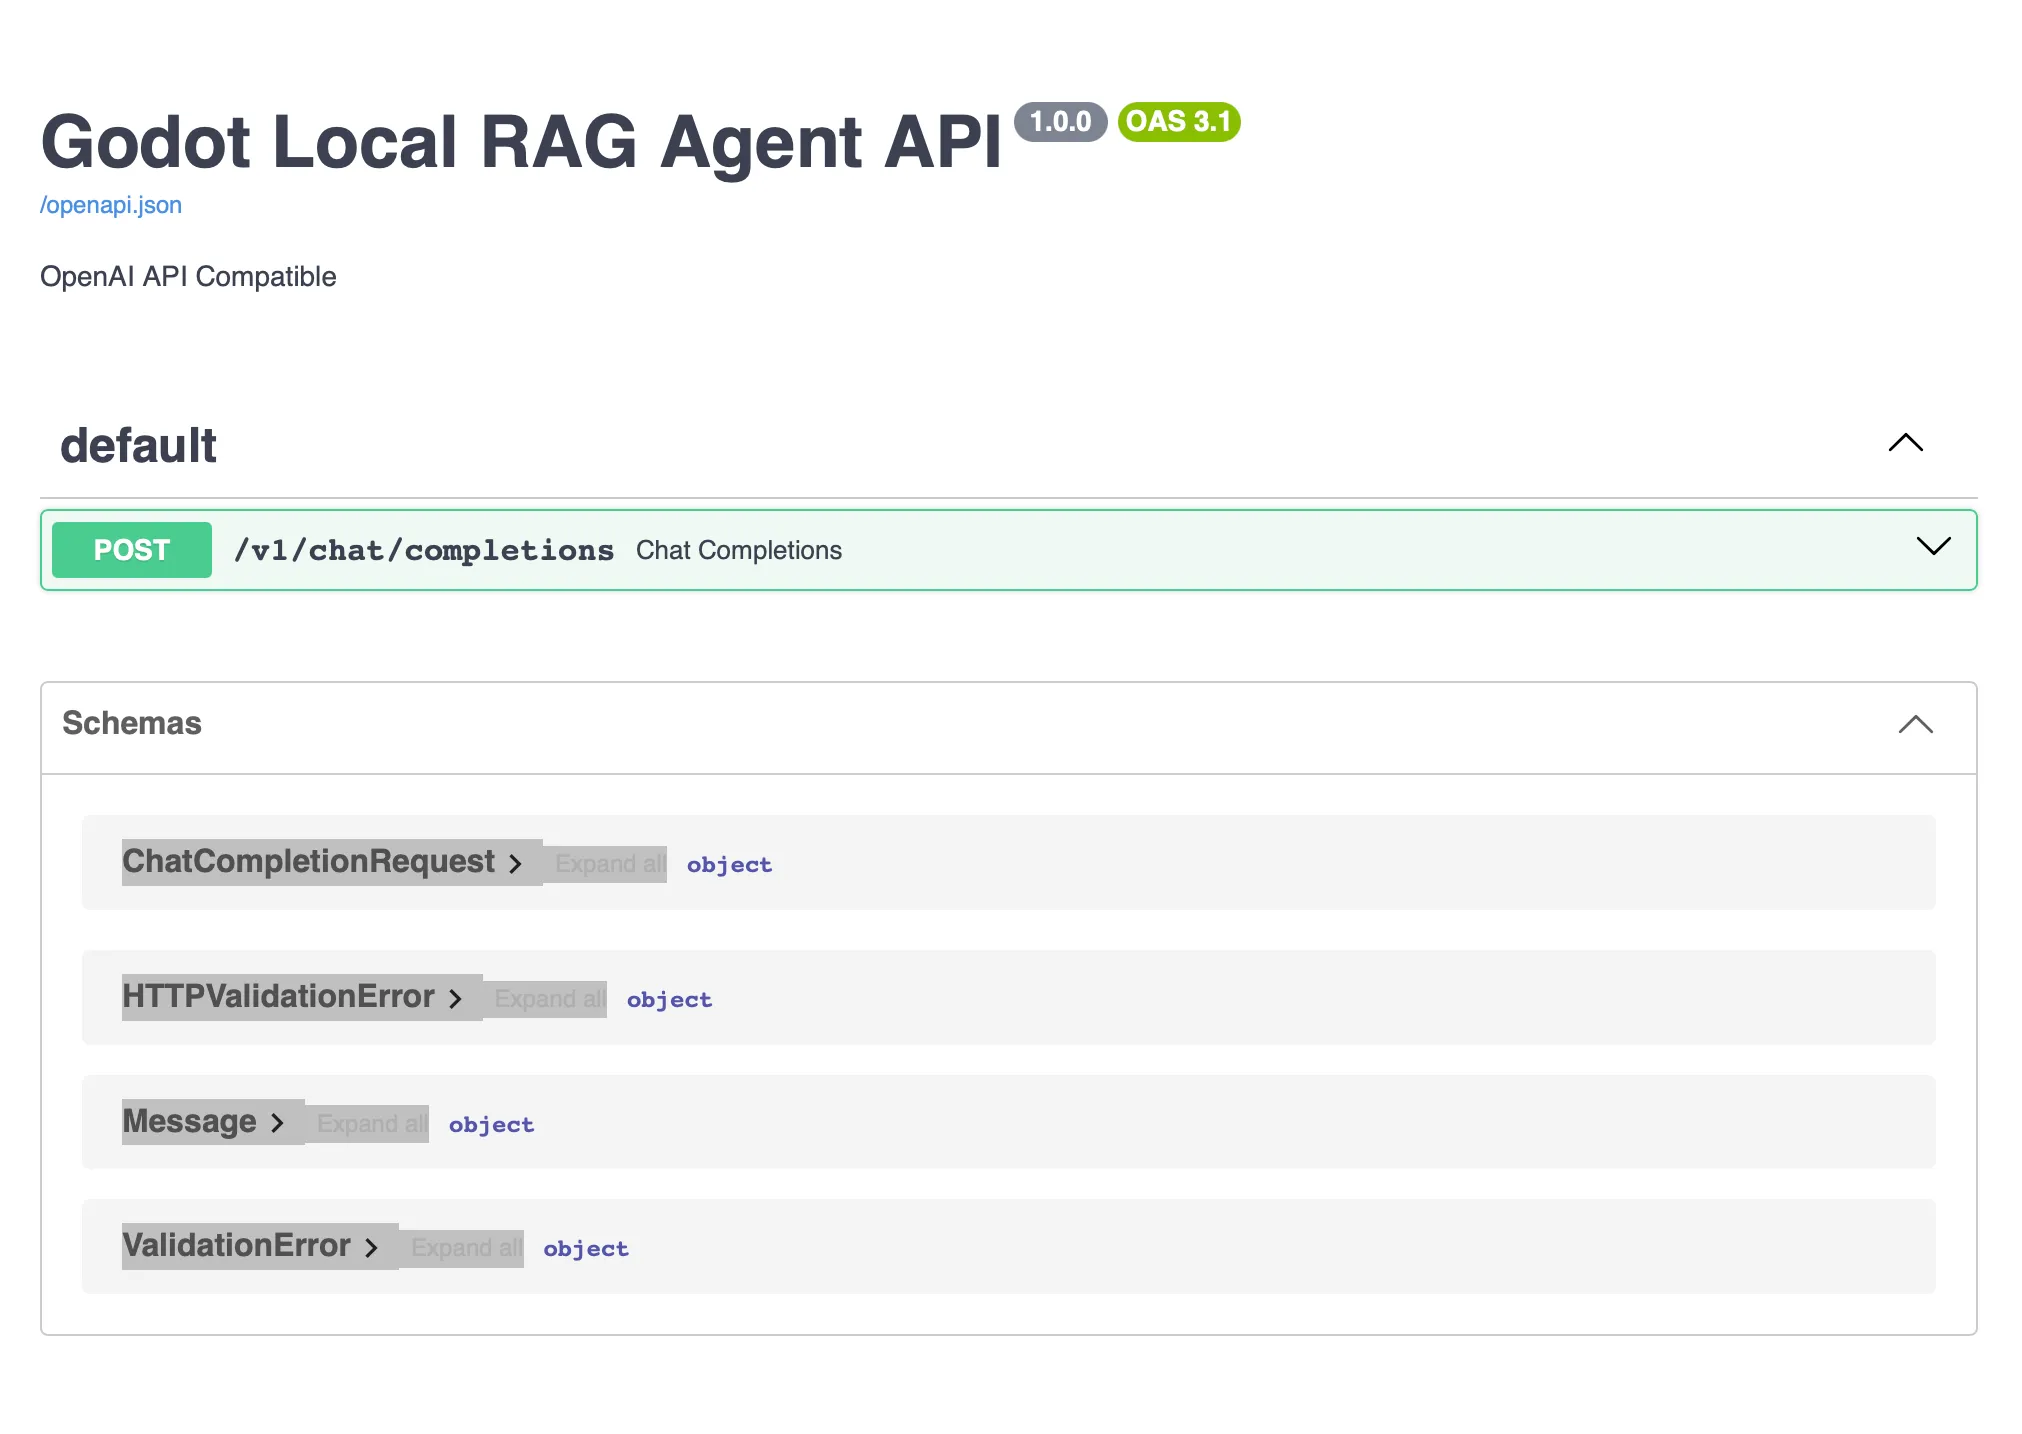
Un chequeo rápido a http://localhost:8000/docs nos confirma que FastAPI está exponiendo el endpoint tal y como hemos programado.
El choque de orquestadores
Con la conexión operativa, le pedí a Continue.dev que refactorizara un método del archivo que tenía abierto. El resultado fue desastroso. El modelo empezó a alucinar, a repetir código y a generar respuestas extremadamente lentas. ¿Qué estaba pasando?
Acababa de provocar un choque de orquestadores.
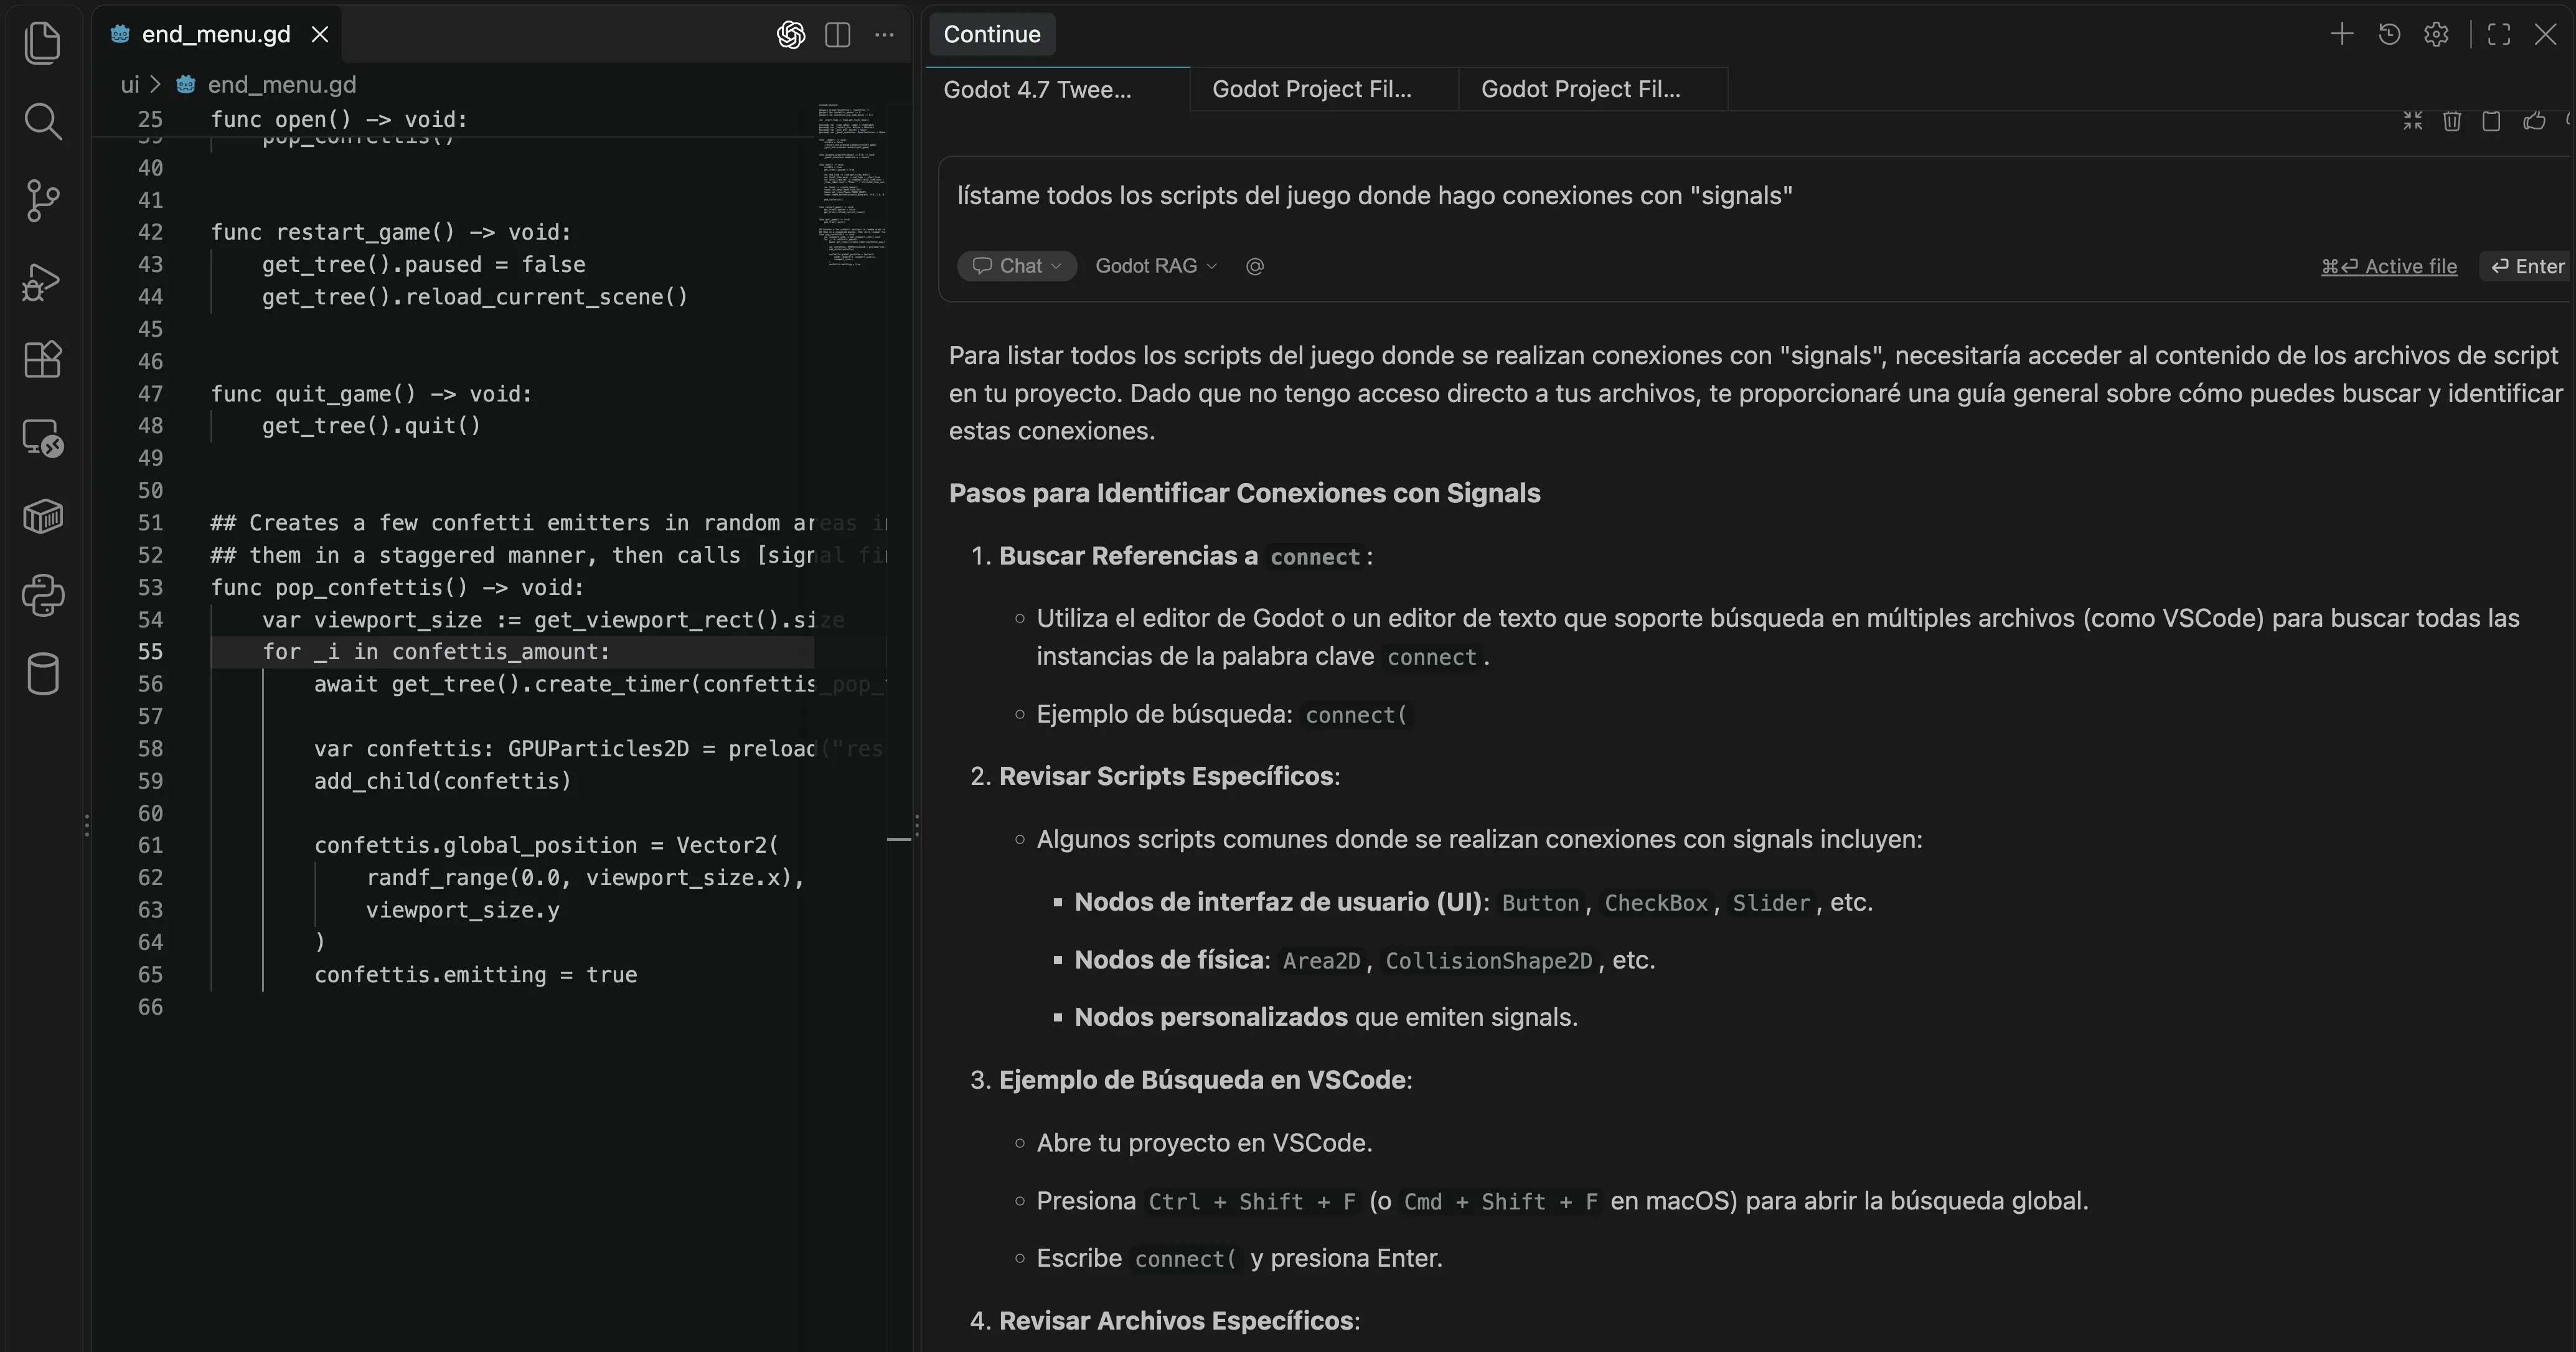
Continue.dev no es un simple cliente de chat; es un agente orquestador en sí mismo. Cuando le haces una consulta en VS Code, la extensión tira de su propio RAG: lee el archivo que tienes abierto, indexa tu workspace local e inyecta todo ese código en el contexto del prompt antes de enviarlo por la API.
Por su parte, el servidor FastAPI recibía esa petición inmensa y se la pasaba a nuestro agente de LangGraph. El enrutador leía la pregunta, veía que hablábamos de código local, y decidía activar su propio nodo retrieve_local_node para buscar en nuestra base de datos vectorial local (ChromaDB).
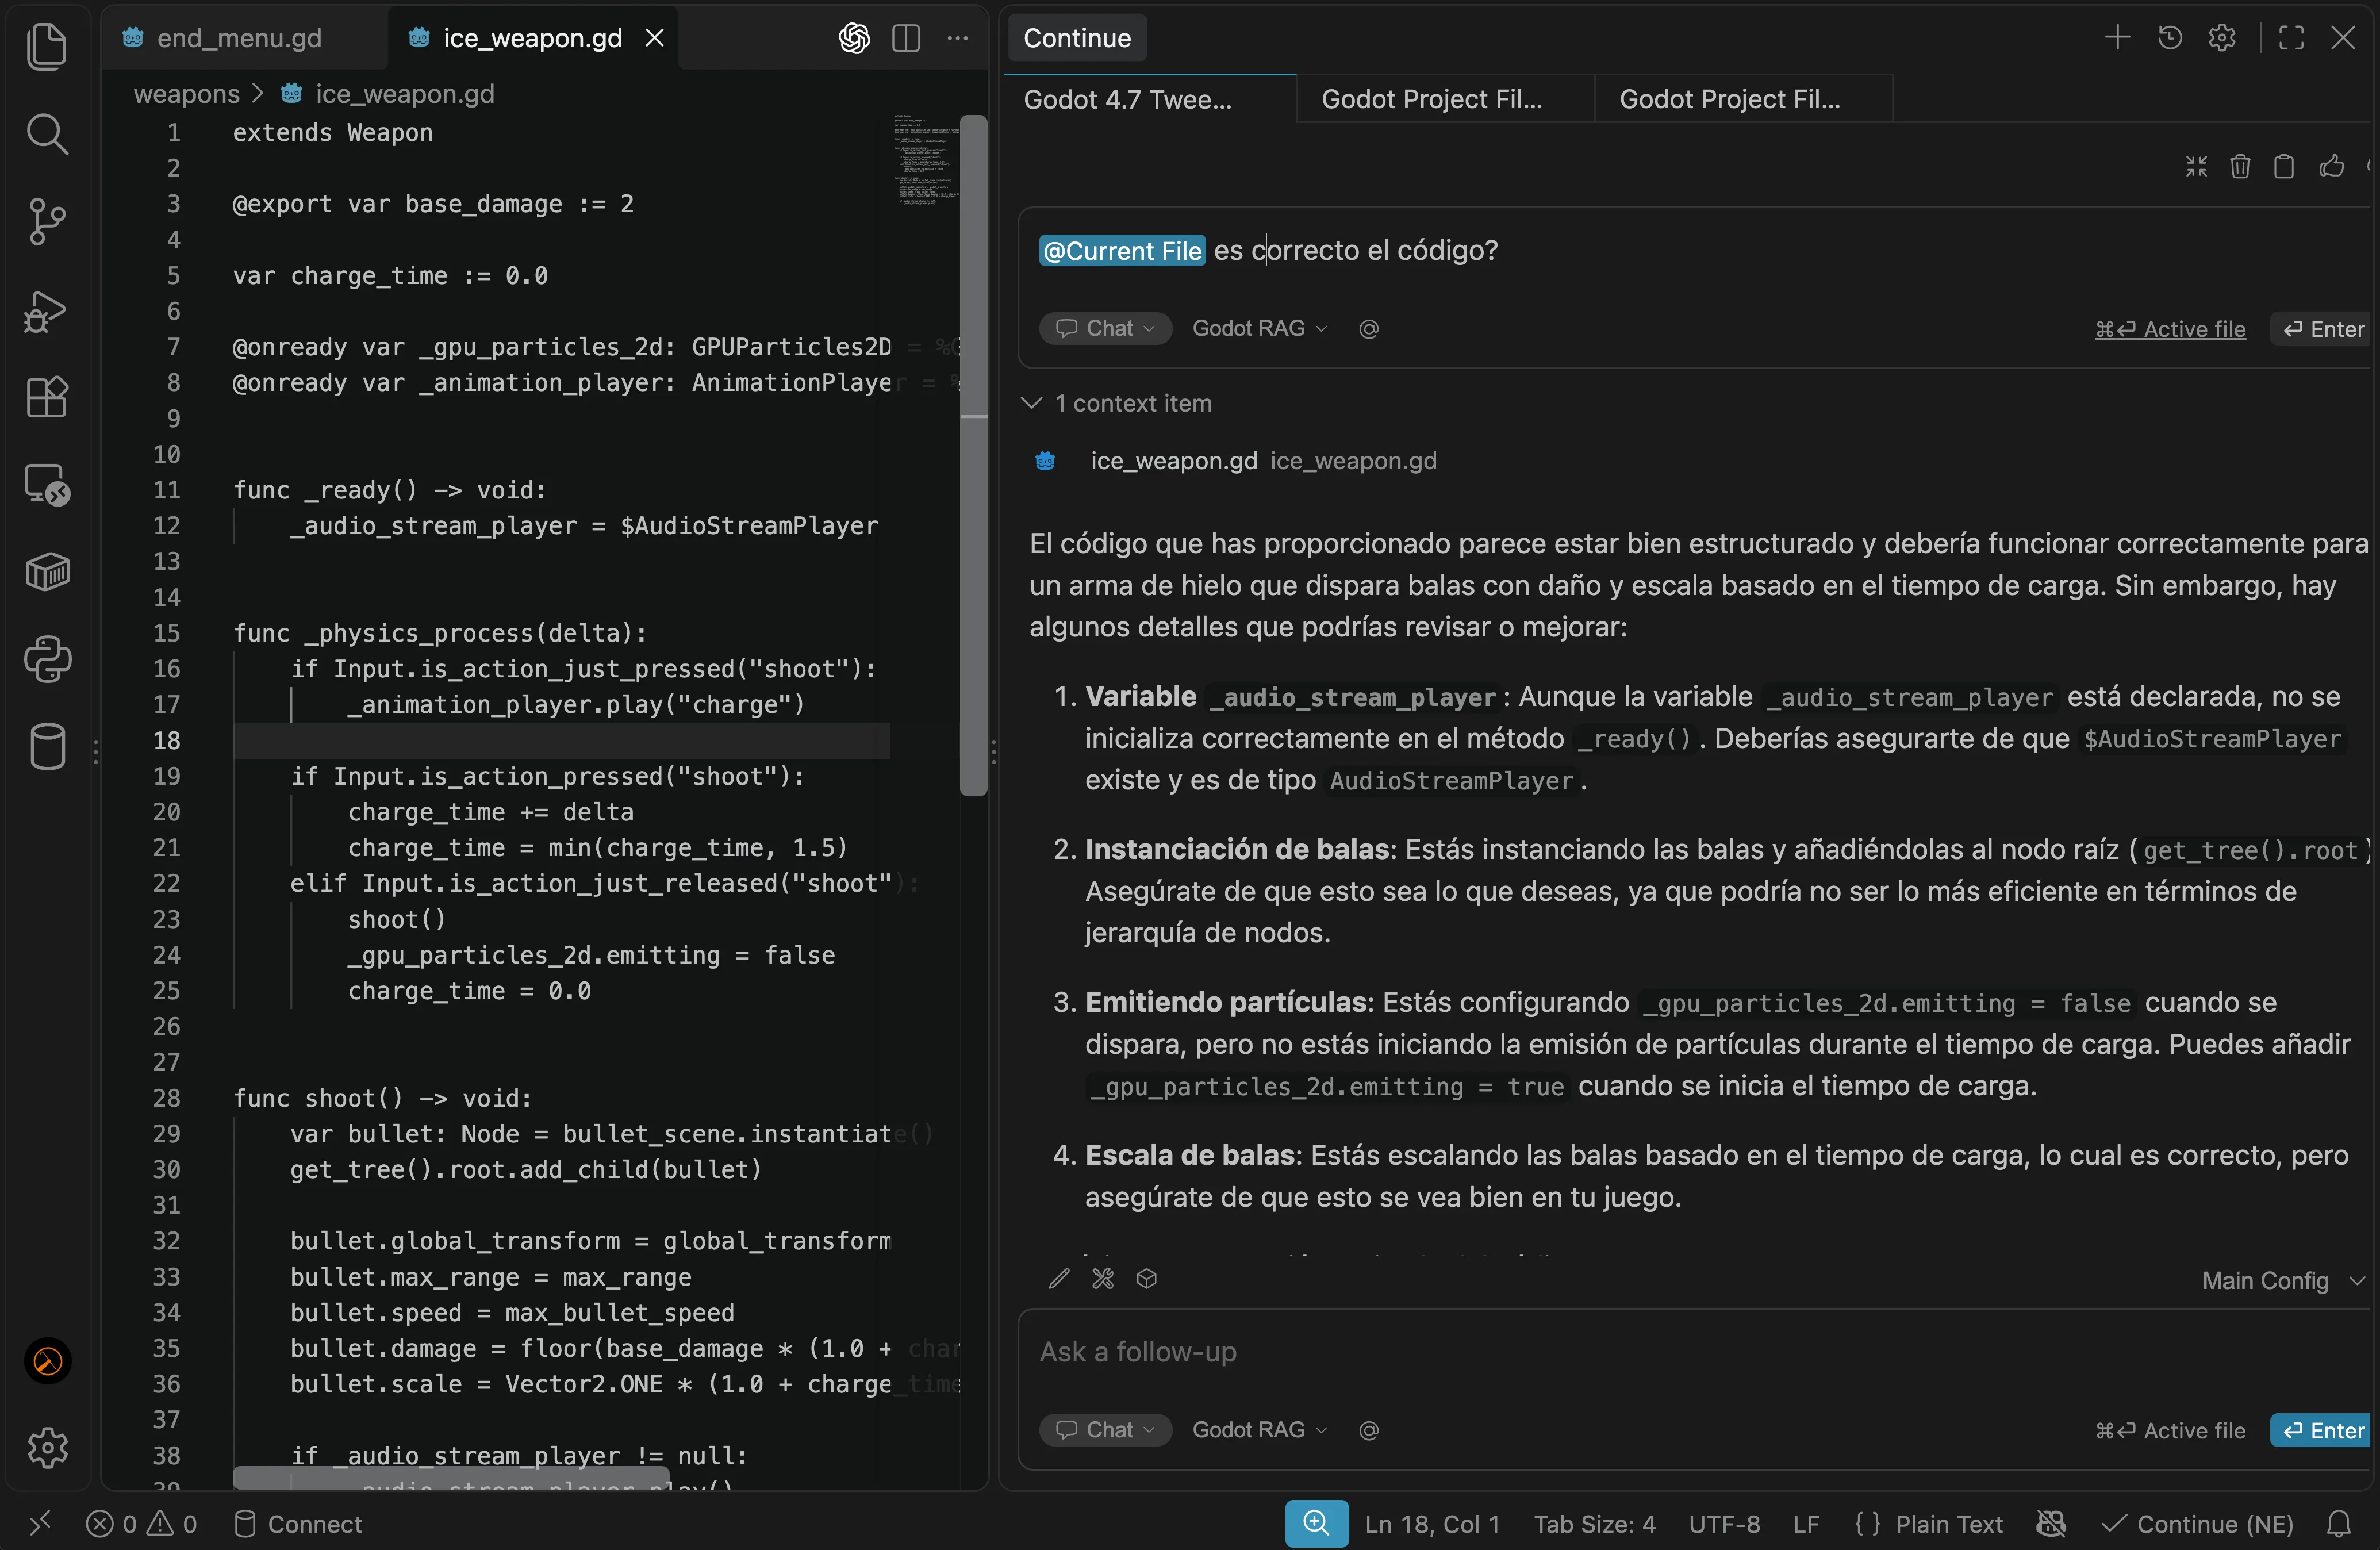
El resultado: le estábamos inyectando a la ventana de contexto del LLM el mismo código por duplicado, fragmentado de dos formas distintas y compitiendo por la atención del modelo. Un procesamiento de tokens totalmente redundante.
Resolviendo el conflicto: Adaptar el agente
Cuando metes un agente dentro de otro agente, uno tiene que ceder el control del contexto.
El IDE siempre va a tener un contexto mucho más preciso y en tiempo real de lo que estás haciendo (sabe en qué línea tienes el cursor y qué archivos tienes modificados sin guardar). Nuestra base de datos vectorial local (ChromaDB) no puede competir con esa inmediatez a menos que la estemos re-indexando de forma recurrente.
La solución fue meter un flag por variable de entorno (DISABLE_LOCAL_RAG_ROUTING) que permite alterar los edges condicionales del grafo para desactivar el nodo retrieve_local_node. Con esto, ganaba en dos escenarios:
- En VS Code: Puedo seguir trabajando delegando en el IDE la inyección del contexto de mi código. LangGraph omite la búsqueda local y se centra exclusivamente en ser un experto de la documentación oficial de Godot 4.7 (
chroma_docs). - En Streamlit: Si quiero levantar una sesión desde la UI del navegador, mantengo el flag apagado y dispongo del RAG híbrido completo.
Con el flujo optimizado y el flag activado para el IDE, la arquitectura queda así:
- Selecciono parte de mi código en VS Code y pregunto cómo adaptarlo a una nueva mecánica.
- Continue.dev empaqueta mi código actual en el prompt.
- FastAPI recibe la petición. El enrutador de LangGraph detecta que necesito saber sobre Godot, extrae la sintaxis o referencias exactas de Godot 4.7 desde ChromaDB y se la inyecta al modelo.
- El LLM local procesa mi código (proporcionado por el IDE) aplicando las referencias exactas de Godot 4.7 (proporcionadas por el vector store de documentación).
Conclusión
Hemos construido un Copilot privado, gratuito, que corre en nuestro propio hardware y que resuelve un problema real: las alucinaciones de un LLM que ha sido entrenado en versiones antiguas de una librería o framework.
Más allá de Godot, este ejercicio demuestra que hoy en día, con herramientas como LangGraph, ChromaDB y FastAPI, desarrollar pequeños agentes personalizados es totalmente asumible, siempre siendo conscientes de que la envergadura del proyecto y su complejidad marcan desde el inicio la viabilidad técnica.
1. Con hardware *modesto* y un mínimo de conocimientos es posible levantar agentes para trabajar en infinidad de casos.
2. La realidad, en mi entorno profesional no va a reemplazar mi stack de trabajo con modelos de frontera bajo suscripción. Al menos hasta que se dé el cruce de hardware más accesible, que pueda ser amortizado en el corto plazo y *open weights LLMs* capaces de correr en menos cantidad de VRAM con la misma o más densidad que los actuales (ya sea mediante nuevos sistemas de entrenamientos o con descarga de capas con MoE mucho más afinados).
Como prometí al inicio de esta serie, he liberado todo el código fuente. Puedes clonar el repositorio, configurar tu .env y probarlo tú mismo.