Desarrolla tu Copilot privado con RAG (Parte 3: UI + métricas con Streamlit)
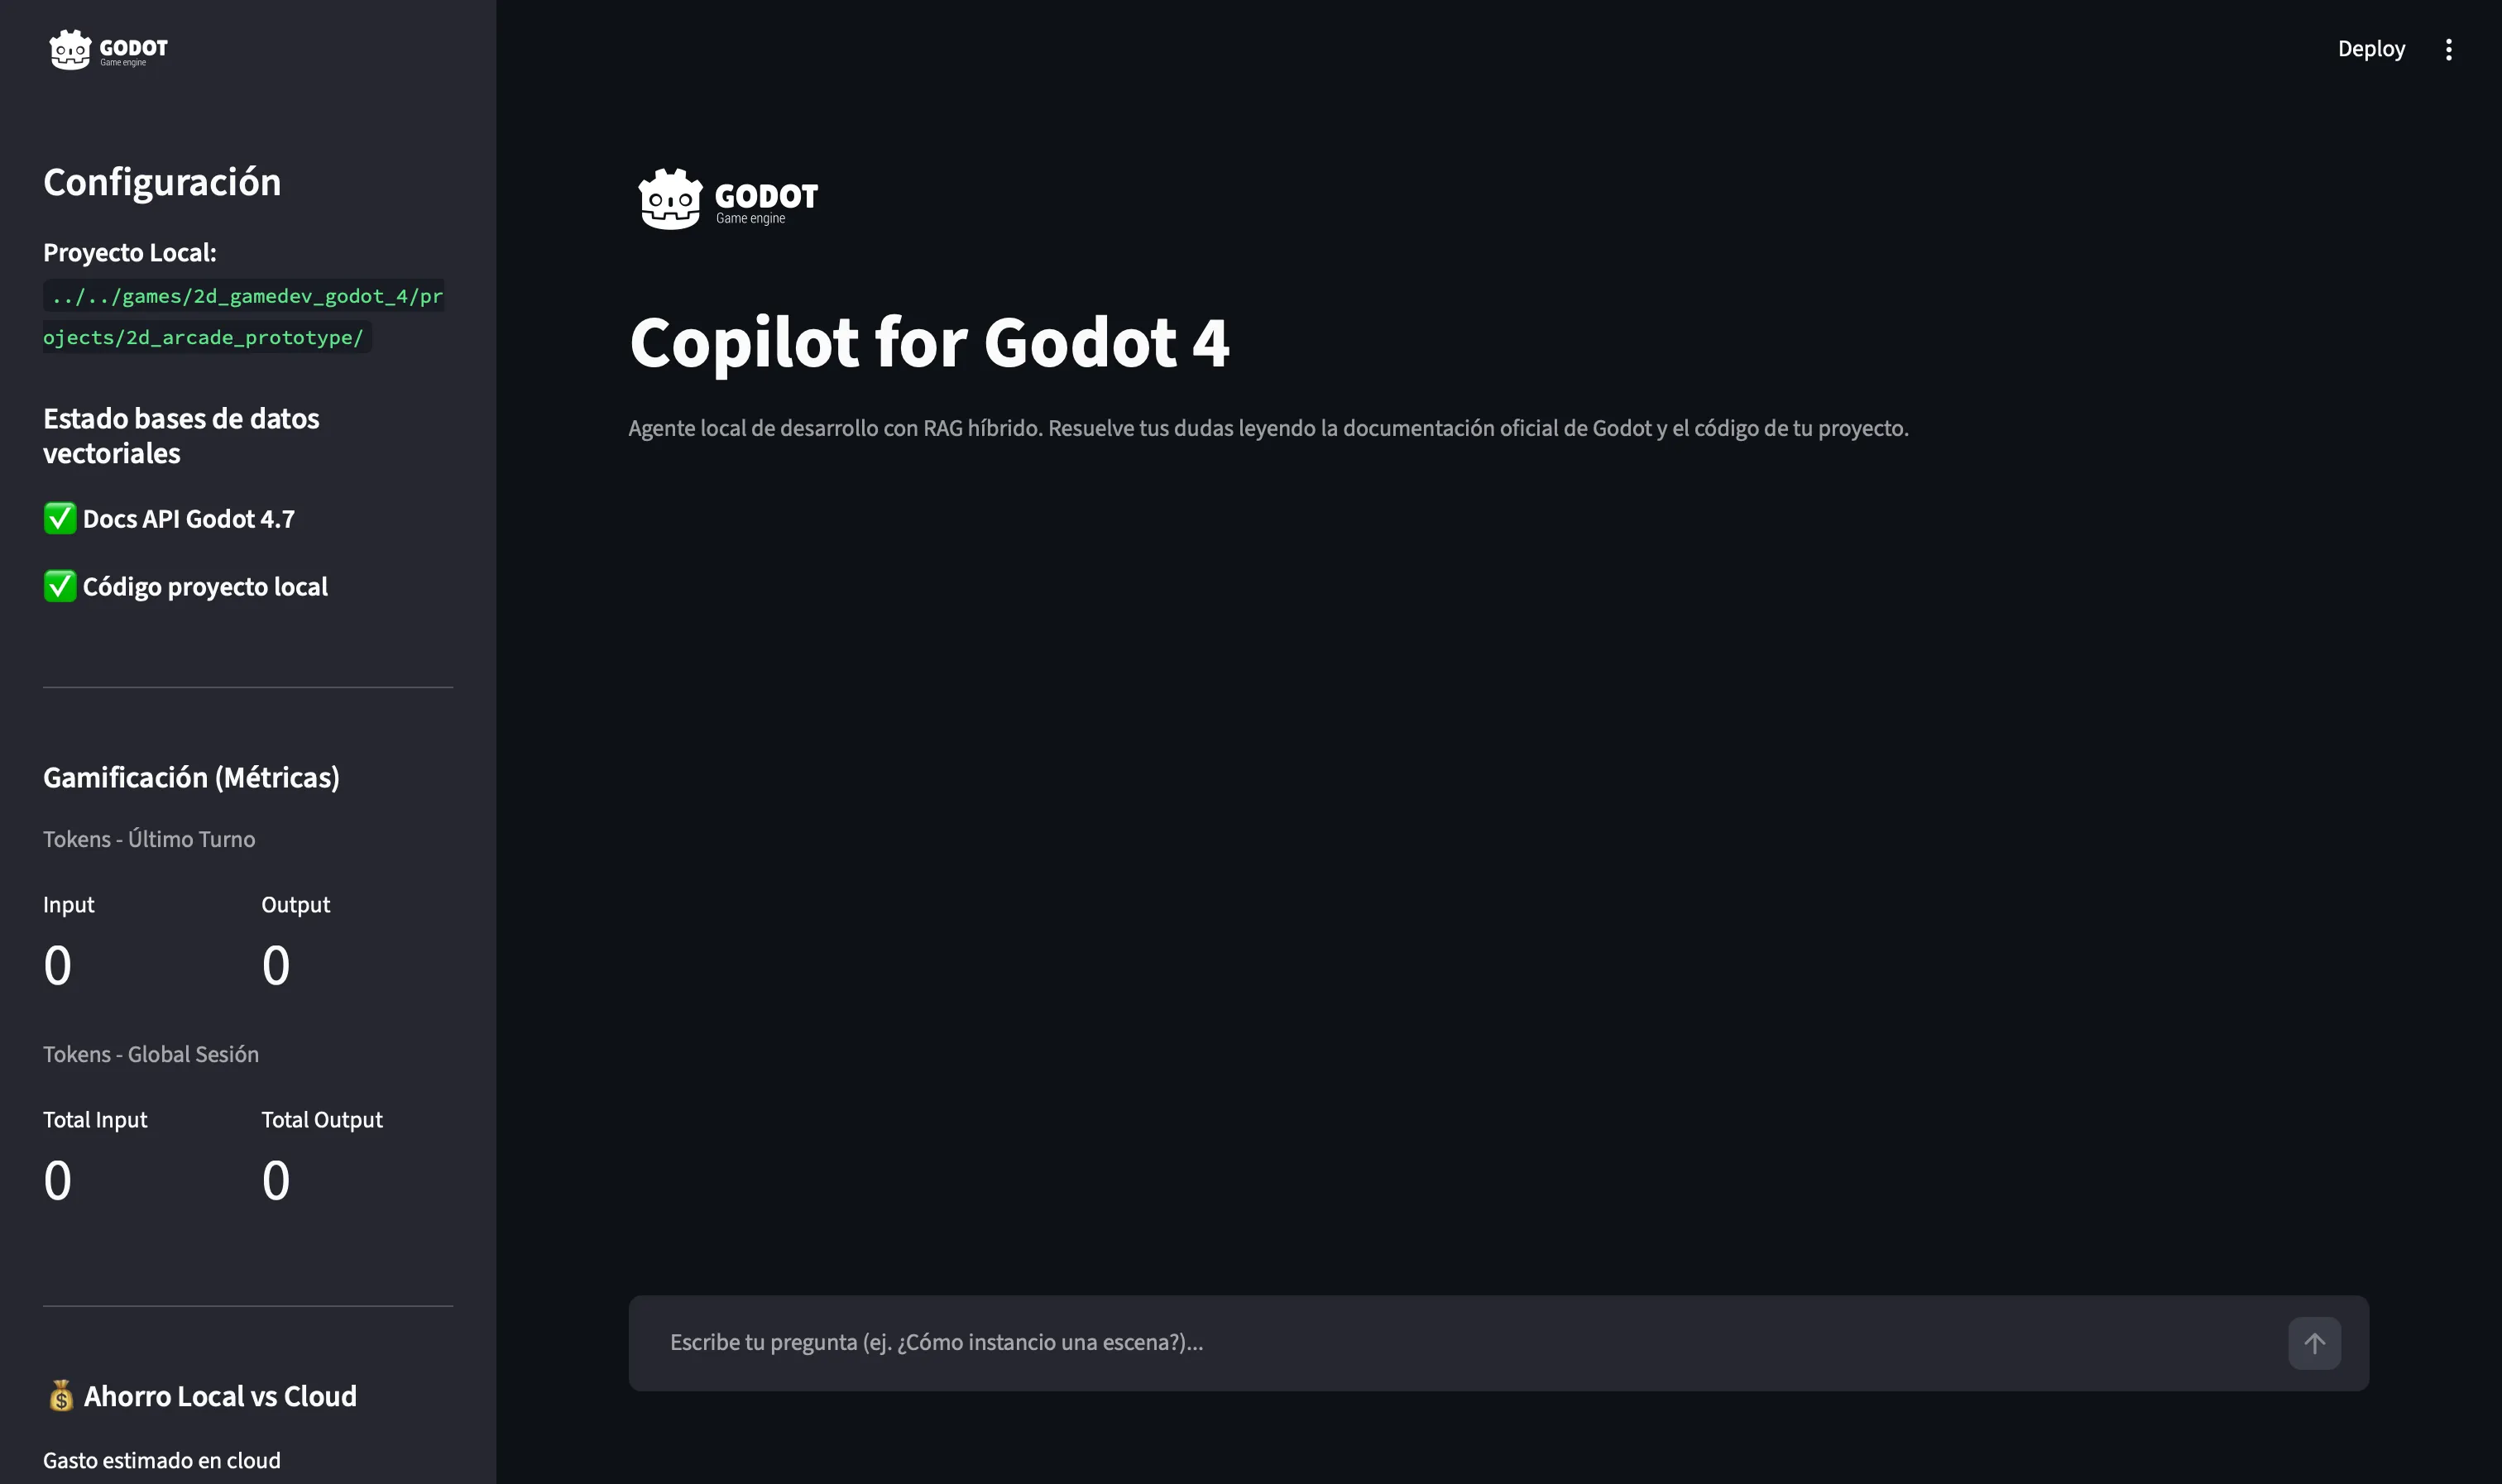
Sacamos al agente del CLI. Construimos una interfaz conversacional con Streamlit para observar en tiempo real las decisiones del enrutador y calcular el coste que nos ahorramos ejecutando IA en local vs servicio cloud.
Estás leyendo la parte 3 de 4.
- 1.Parte 1: Arquitectura y stack
- 2.Parte 2: Agente con enrutamiento
- 3.👉 Parte 3: UI + métricas con Streamlit
- 4.Parte 4: FastAPI, VS Code y el choque de orquestadores
En la segunda parte logramos que nuestro enrutador con LangGraph decidiera inteligentemente cuándo leer la documentación de Godot 4.x y cuándo buscar dentro de los scripts locales. Comprobar por terminal que el sistema funciona y no alucina está genial para hacer debug, pero no es la forma más cómoda para interactuar con un asistente de programación.
Necesitaba una interfaz visual usable, conversacional, donde pudiera mantener el contexto de la sesión y copiar bloques de código fácilmente.
Por qué Streamlit y no React
Para la interfaz, el primer impulso podría haber sido levantar un proyecto en React con Tailwind o Shadcn. Sin embargo, eso suponía añadir más piezas, dependencias (Node, CORS, builds) y una complejidad que nos desviaba del objetivo de construir un “prototipo rápido”.
Streamlit fue la elección obvia: 100% Python, sin salir del venv y en un solo archivo (ui.py).
Pero Streamlit me aportó una ventaja técnica mucho mayor que la simple rapidez. Al estar programado en Python, no tuve que montar peticiones HTTP ni APIs intermedias; pude importar el grafo de LangGraph directamente en la interfaz.
import streamlit as st
import asyncio
import json
import os
import sys
from pathlib import Path
from dotenv import load_dotenv
from langchain_core.messages import HumanMessage, AIMessage

from src.graph import app as agent

[...]
Visualizando el núcleo del enrutador
Tener acceso directo al grafo del agente desde la UI permite “observar” sus eventos internos en tiempo real. Aprovechando la API asíncrona de LangGraph (astream_events), pude interceptar el momento exacto en el que el nodo enrutador (router_node) toma su decisión y pintar una etiqueta dinámica justo encima de la respuesta de texto:
- 📘 Contexto: Documentación de Godot (si se pregunta por conceptos del motor).
- 📁 Contexto: Proyecto Local (si necesito consultar código fuente de mi juego).
- 🧠 Contexto Híbrido (combinación de ambos casos).
- 💬 Contexto: (chat general o preguntas off-topic).
[...]

async def process_stream():
    initial_state = {"messages": st.session_state.messages}
    full_response = ""
    decision = ""

    async for event in agent.astream_events(initial_state):

        if event["event"] == "on_chain_end" and event["name"] == "router_node":
            output = event["data"].get("output", {})
            if isinstance(output, dict) and "router_decision" in output:
                decision = output["router_decision"]

            badges = {
                "docs": "📘 **Contexto:** Documentación de Godot",
                "local": "📁 **Contexto:** Proyecto Local",
                "both": "🧠 **Contexto Híbrido:** Docs Godot + Proyecto",
                "none": "💬 **Contexto:** Chat General"
            }
            badge = badges.get(decision, "🧠 **Contexto Híbrido**")
            status_placeholder.caption(badge)

        [...]

final_text = asyncio.run(process_stream())
Memoria de estado: JSON vs Checkpointers
Un requisito indispensable para cualquier Copilot de programación es tener memoria de la sesión en curso. Aquí tomé una decisión de diseño importante (teniendo en cuenta que se trata de un prototipo).
LangGraph ofrece herramientas avanzadas para manejar el estado llamadas checkpointers (como MemorySaver o SqliteSaver). Están diseñados para gestionar múltiples hilos de conversación simultáneos, aplicar compresión (resúmenes automáticos de contextos largos) y permitir time-travel/rewind (volver a un estado anterior del grafo).
Para este prototipo solodev, usar todo eso era sobreingeniería. Opté por una solución mucho más pragmática: el histórico de conversación se persiste en un archivo chat_history.json local a nivel de aplicación (UI), no como memoria gestionada por el grafo. Cada vez que lanzo una petición, la UI inyecta el historial reciente de nuevo en el grafo (LangGraph). Es más que suficiente para este caso de uso: si cierro el navegador y retomo la sesión mañana, la conversación sigue exactamente donde la dejé.
[...]

HISTORY_FILE = DATA_DIR / "chat_history.json"

[...]

def load_history():
    if HISTORY_FILE.exists():
        try:
            with open(HISTORY_FILE, "r", encoding="utf-8") as f:
                data = json.load(f)
                messages = []

                if isinstance(data, list):
                    msg_list = data
                else:
                    msg_list = data.get("messages", [])

                for msg in msg_list:
                    if msg["type"] == "human":
                        messages.append(HumanMessage(content=msg["content"]))
                    elif msg["type"] == "ai":
                        messages.append(AIMessage(content=msg["content"]))

                return messages
        except Exception:
            return []
    return []

def save_history(messages):
    DATA_DIR.mkdir(parents=True, exist_ok=True)
    data = {
        "messages": []
    }
    for msg in messages:
        if isinstance(msg, HumanMessage):
            data["messages"].append({"type": "human", "content": msg.content})
        elif isinstance(msg, AIMessage):
            data["messages"].append({"type": "ai", "content": msg.content})
    with open(HISTORY_FILE, "w", encoding="utf-8") as f:
        json.dump(data, f, indent=2)

def clear_context():
    st.session_state.messages = []
    if HISTORY_FILE.exists():
        HISTORY_FILE.unlink()

if not st.session_state.messages and HISTORY_FILE.exists():
    st.session_state.messages = load_history()

[...]

st.session_state.messages.append(AIMessage(content=final_text))
        save_history(st.session_state.messages)
El “Game Juice”: Calculadora de ahorro en tiempo real
Para darle un poco de sentido práctico a esta serie de posts y al anterior sobre cómo montar un server de inferencia local, quería mostrar gráficamente el valor de estar consumiendo IA local frente a tirar de APIs de terceros como GPT-5.6-terra de OpenAI o Claude Sonnet 5 de Anthropic.
Aprovechando que Ollama devuelve metadatos de uso, pinté un panel lateral en Streamlit que captura los tokens exactos consumidos en cada turno (sumando el contexto de entrada inyectado por el RAG y los tokens generados por el modelo).
[...]

final_text, t_in, t_out, t_reasoning = asyncio.run(process_stream())

st.session_state.total_input_tokens += t_in
st.session_state.total_output_tokens += t_out

render_token_stats(t_in, t_out, t_reasoning)

st.session_state.messages.append(AIMessage(content=final_text))

[...]
Para darle ese toque de Game Juice como se suele decir en “argot gamedev”, añadí un marcador global que traduce esos tokens consumidos a dinero. Tomando como referencia los precios estándar del modelo Claude Sonnet 5 ($2 por millón de tokens de entrada y $10 por millón de salida), la interfaz calcula en vivo los dólares que me habría costado esa sesión contra la API de Anthropic.
Ver cómo el contador sube a un par de dólares tras unas horas de consultas intensivas (debido a los cientos de fragmentos de código inyectados en el contexto en cada turno) es el mejor argumento demostrable para justificar la inversión en hardware propio (o explotación si ya se dispone de él) para proyectos o side-projects que no requieran ventanas de contexto masivas o de excesiva complejidad.
¿Y ahora qué?
Ya tenemos un RAG híbrido, un enrutador inteligente y una UI funcional ejecutándose en local, de forma privada y con métricas en tiempo real. En este punto podríamos dar el prototipo por terminado.
Sin embargo, mi idea inicial para este “Copilot” era usarlo mientras programo en mi IDE (VS Code), sin tener que alternar constantemente entre el código y una pestaña del navegador. El siguiente paso lógico era conectar el sistema directamente al IDE.
Y es en ese punto donde todo saltó por los aires. En la cuarta y última parte de la serie, mostraré cómo exponer al agente tras una API (con FastAPI) que replica el estándar de OpenAI, qué es el “choque de orquestadores” y qué lecciones de arquitectura aprendí al intentar integrar un agente RAG local dentro de la extensión Continue.dev.