Desarrolla tu Copilot privado con RAG (Parte 2: Agente con enrutamiento)
Implementación del agente. Vectorizar la documentación de Godot junto a mi propio código, y diseño del enrutador con LangGraph para que el agente recupere el contexto adecuado.
En el primer post definimos la arquitectura: un agente 100% local que prevenga las potenciales alucinaciones del LLM construyendo código de versiones deprecadas de Godot (o no con la que vamos a trabajar). Con la teoría clara ahora toca implementarlo y probarlo por CLI.
Para que este prototipo rápido funcione de forma fluida y sin sobreingeniería, me apoyo en las últimas versiones de LangChain[1.3.x] y LangGraph[1.2.x] (en fecha de publicación de este post). El objetivo de esta fase era doble: alimentar las bases de datos vectoriales (RAG) y orquestar el flujo para poder interactuar con el agente desde la terminal.
Fase 1: Ingesta de datos en ChromaDB
Un LLM sin contexto tiene tolerancia o tendencia a inventarse las respuestas (sobre todo si no tenemos acceso a configurar parámetros como Top-P o Temperatura). Para solucionarlo, instancié dos bases de datos vectoriales independientes con ChromaDB, que al guardar los datos localmente encajaba muy bien con la idea del proyecto.
- La documentación oficial (
chroma_docs): Como comenté en el post anterior, evité el HTML. Escribí un pequeño script en Python encargado de clonar la rama 4.7 (justo la que versión de Godot con la que estoy trabajando y de la que quiero referencias válidas) del repositorio oficialgodot-docsy procesa directamente los archivos.rst. El resultado son fragmentos de texto mucho más limpios y estructurados para los embeddings. - El código del proyecto (
chroma_local): Otro script se encarga de escanear de forma recursiva el directorio de mi juego para vectorizar todos los scripts.gd. Esa extensión nativa de Godot es donde reside el código fuente del juego como texto plano.
El límite del RAG y el “documento sintético”
Algo que por experiencia propia me he topado las primeras veces al trabajar con RAG y es una de las limitaciones clásicas: durante las primeras pruebas si le preguntaba al agente “¿Cuántos scripts tengo en el proyecto?”, fallaba. La base de datos vectorial busca por similitud semántica, no procesa consultas SQL como un SELECT COUNT(*). El modelo recibía cuatro fragmentos aislados de mi código y no tenía forma de ver la imagen global.
En el siguiente fragmento se ve más claro: el retriever emite un máximo de 4 resultados.
def get_local_vectorstore() -> Chroma:
	return Chroma(
		collection_name="godot_local_project",
		persist_directory=str(CHROMA_LOCAL_DIR),
		embedding_function=get_embeddings()
	)

#...

def get_local_retriever(k: int = 4):
	return get_local_vectorstore().as_retriever(search_kwargs={"k": k})
Entonces, ¿qué solución tiene si no es capaz de saber cuánta información o ficheros se han vectorizado en la ingesta de datos?
Para solucionarlo, generé un documento propio (o sintético) que inyecté en la misma base de datos. Modifiqué el script de ingesta local para que, antes de procesar los vectores, contara los archivos .gd y generara un texto plano en memoria con el árbol de directorios completo. Este “resumen global” se vectoriza como si fuera un archivo más. Ahora, ante preguntas sobre la estructura del proyecto, ChromaDB recupera este documento y el LLM responde con precisión. A efectos prácticos es como incluir un índice con contadores más unas breves instrucciones a la ingesta de documentos a vectorizar.
En este fragmento del script que define la ingesta del código fuente del proyecto (chroma_local) se ve como monto con este documento y luego se añade a la colección de fragmentos (splits) a vectorizar en ChromaDB, así funciona este hack:
def run_ingestion():

	#...

	# Inyecto el relative path en metadata para cada fichero/documento para que esté disponible en el documento sintético
	relative_paths = []
	for doc in docs:
		abs_path = doc.metadata.get("source", "")
		if abs_path:
			try:
				rel_path = os.path.relpath(abs_path, GODOT_PROJECT_PATH)
				doc.metadata["relative_path"] = rel_path
				relative_paths.append(rel_path)
			except ValueError:
				pass

	print("Chunking source code...")
	text_splitter = RecursiveCharacterTextSplitter(
			chunk_size=1000,
			chunk_overlap=200,
			add_start_index=True,
		)
	splits = text_splitter.split_documents(docs)

	print("Generating synthetic global architecture document...")
	tree_structure = "\n".join(f"- {p}" for p in relative_paths)
	synthetic_content = f"""Global summary of the local project architecture:
The project contains a total exact of {len(docs)} .gd scripts.
The complete list of script files and folders is the following:
{tree_structure}

Use this information exclusively if the user asks how many scripts they have, how the project is organized, or which files exist in general.
"""

	synthetic_doc = Document(
		page_content=synthetic_content,
		metadata={
			"source": "synthetic_global_summary",
			"relative_path": "Resumen_Global.txt"
		}
	)

	# Una vez construido el documento lo incluyo a los splits o fragmentos a vectorizar
	splits.append(synthetic_doc)

	#...

	print(f"{len(splits)} local chunks generated (including the global summary).")

	print("Saving embeddings in local ChromaDB...")
	Chroma.from_documents(
		documents=splits,
		embedding=get_embeddings(),
		persist_directory=str(CHROMA_LOCAL_DIR),
		collection_name=COLLECTION_NAME
	)
	print(f"Data ingestion completed successfully. Vector database ready at: {CHROMA_LOCAL_DIR}")

	#...
Fase 2: Orquestando con LangGraph
El siguiente problema era evitar que el agente lanzara búsquedas contra ambas bases de datos por defecto, lo cual es ineficiente y consume contexto innecesario. Necesitaba un enrutador capaz de discernir cuando invocar a la base de datos adecuada.
Utilizando LangGraph, diseñé un grafo con los siguientes nodos:
- Router Node: Evalúa la pregunta y decide la vía de actuación.
- Retrievers: Dos nodos separados (retrieve_docs_node y retrieve_local_node).
- Generate Node: Recibe el contexto recuperado y redacta la respuesta final.
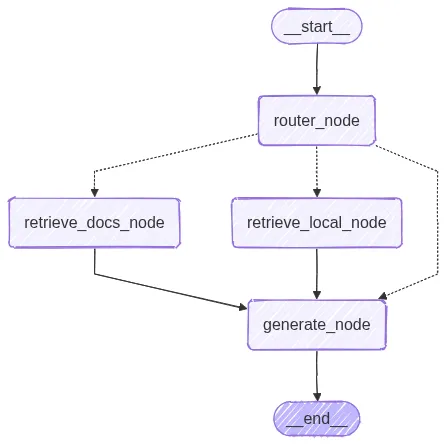
El detalle técnico más importante aquí fue la gestión del estado (AgentState). Si le pasaba todo el historial de la conversación al enrutador, el agente se confundía con temas pasados. La clave fue forzar al Router Node a evaluar solo el último mensaje del usuario (state["messages"][-1].content). Con esto resuelto ahora sí, si nombro un archivo propio, va a local; si pregunto sobre una clase del motor Godot, va a docs.
Probando el agente en la Terminal
Antes de pensar en implementar una UI o extensiones de VS Code, necesitaba validar que la lógica del grafo funcionara según lo previsto. Monté una pequeña app de CLI con la ayuda de librería typer para poder gestionar las bases de datos (ingesta de datos, chunking y vectorización), quedando algo tal que así:
python scripts/cli.py reset-docs  # Descarga y vectoriza la API de Godot 4.7
python scripts/cli.py reset-local # Escanea el proyecto y vectoriza los .gd
Cada vez que lanzo estos comandos las base de datos de ChromaDB se elimina y se alimenta de nuevo. Para la pequeña escala de este proyecto es viable y esto evita duplicidades en los documentos vectorizados.
Para la prueba funcional, escribí un script de testeo (test_agent.py) que ataca directamente al grafo por consola. Le lancé una pregunta específica sobre mi proyecto:
$ python test_agent.py "¿Cuántos scripts tengo en mi proyecto y cómo se organizan?"Output del CLI:
[Router Node] Analizando pregunta...
[Router Node] Decisión tomada: LOCAL
[Retriever Local] Buscando similitudes en ChromaDB (Proyecto Local)...
[Retriever Local] Recuperado Documento Sintético
[Generate Node] Escribiendo respuesta...

Agente:
En tu proyecto tienes un total de 46 scripts. La organización general del proyecto se puede resumir como sigue:

- **Pickups**: Contiene scripts relacionados con los objetos que el jugador puede recoger.
  - `item.gd`
  - `pickup.gd`
  - `healing_item.gd`
  - `chest/chest.gd`

- **Mobs**: Scripts para enemigos o criaturas móviles.
  - `mob.gd`

- **Weapons**: Contiene scripts relacionados con armas y balas.
  - `bullet.gd`
  - `weapon.gd`
[...]
Ahora una prueba para aislar la ejecución hacia el nodo de RAG que contiene la documentación y con una pregunta que me sirve para verificar que estoy en la versión de la documentación correcta y no en una anterior que el LLM tenga de su fase de entreno:
$ python test_agent.py "¿Puedo seguir utilizando el nodo Spatial o Node3D?"Output del CLI:
[Router Node] Analizando pregunta...
[Router Node] Decisión tomada: DOCS
[Retriever Docs] Buscando similitudes en ChromaDB (Godot API)...
[Generate Node] Escribiendo respuesta...

Agente:
En Godot 4, el nodo `Spatial` ha sido renombrado a `Node3D`. Por lo tanto, si estás trabajando con Godot 4.7, debes utilizar `Node3D` en lugar de `Spatial`.

Referencia: Documentación de Godot
Por último una consulta híbrida, el enrutador debe forzar al agente a paralelizar consultas hacia las 2 bases de datos:
$ python test_agent.py "¿Estoy implementando bien en mi código el uso de _input y _unhandled_input?" Output del CLI:
[Router Node] Analizando pregunta...
[Router Node] Decisión tomada: BOTH
[Retriever Local] Buscando similitudes en ChromaDB (Proyecto Local)...
[Retriever Docs] Buscando similitudes en ChromaDB (Godot API)...
[Generate Node] Escribiendo respuesta...

Agente:
Basándome en la documentación de Godot y el código proporcionado, parece que estás utilizando correctamente los métodos `_input` y `_unhandled_input`. Aquí hay un análisis detallado:

### En `chest.gd`

```gdscript
func _unhandled_input(event: InputEvent) -> void:
        if event.is_action_pressed("interact") and is_player_near:
			_animation_player.play("open")
			set_process_unhandled_input(false)
[...]

### Conclusión

Ambos métodos `_input` y `_unhandled_input` están siendo utilizados de manera apropiada según su propósito:

- **_input**: Para manejar eventos de entrada específicos que afectan directamente a la interfaz de usuario.
- **_unhandled_input**: Para detectar cambios en el tipo de entrada (teclado/mouse vs. controlador) y ajustar el comportamiento del personaje o cámara.

No hay evidencia de errores obvios en tu implementación basada en los fragmentos proporcionados.
[...]
A primera vista el agente funciona correctamente. El enrutador aisló la búsqueda a la carpeta local en el primer caso, el retriever encontró el documento sintético inyectado previamente, y el modelo generó una respuesta basada en los ficheros de mi proyecto local de Godot. En el segundo caso la consulta es exclusiva a la documentación oficial vectorizada y en el último caso hace una consulta híbrida ya que necesita de ambos contextos para generar una respuesta.
Con el backend operativo, el siguiente paso es sacarlo de la consola. En el próximo artículo montaremos una API con FastAPI simulando el estándar de OpenAI y una interfaz con Streamlit para visualizar en tiempo real, a modo demostrativo, el consumo de tokens y el ahorro en costes frente a APIs de pago.